
上一篇,我們嘗試把 activation 翻成文字。但一段讀起來很合理的 explanation,不一定忠實反映模型真正使用的資訊。今天,我們想再往前問一步:模型沒有寫出來的中間資訊,我們能不能看見?如果改掉它,模型的回答會不會跟著變?例如,模型看到:
The number of legs on the animal that spins webs is
然後直接回答:
8
我們很容易替它補出一條推理:
會結網的動物
↓
spider
↓
蜘蛛有幾條腿?
↓
8
但模型沒有寫出 spider。這可能是它實際使用的中間步驟,也可能只是我們覺得合理的解釋。今天介紹的 Jacobian Lens(J-Lens),就是一個用來尋找這類內部資訊的工具。它利用模型自己的後續 computation,讀取那些還沒被說出來、卻可能被轉成語言的 representations。[1] 簡單來說你可以想像模型在運算的過程中一直有一個逐漸要成型的最後要說出口的話,而 J-Lens 就是想試著在某一層攔截這個「半成品」看能不能讀出計算、思考到這為止,模型「腦」中的東西。
標題裡的「想法」是一個方便理解的說法,不是預先認定模型具有主觀體驗。我們真正要研究的是:這些內部表徵能不能被讀出、被報告,以及被後續計算使用。
在理解 J-Lens 的原理之前,先簡單看看論文裡的案例。在論文的蜘蛛案例中,研究者用 J-Lens 讀取中間 layers 的 activation,看到 spider;到了較後面的 layers,readout 才轉向答案相關的詞。[1] 這提供了一條線索,模型的中間狀態,似乎包含了「會結網的動物是蜘蛛」這一步的資訊。
到這裡只是 observation。spider 也可能只是和答案相關,卻沒有被真正使用。因此,研究者進一步在選定的 layers 與 positions,交換 spider 和 ant 對應的 lens coordinates,再讓模型繼續執行。問題文字沒有改,模型最支持的答案卻從 8 變成 6。[1]
這裡的介入不是把 prompt 裡的動物改成螞蟻,也不是直接提高答案 6 的 logit,而是在模型內部調整中間 concept 的表徵。如果後續答案按照預測改變,我們就得到比「看到一個合理的詞」更強的證據:相關內部表徵對這次回答具有因果影響。那麼,J-Lens 是怎麼找到這些表徵的?
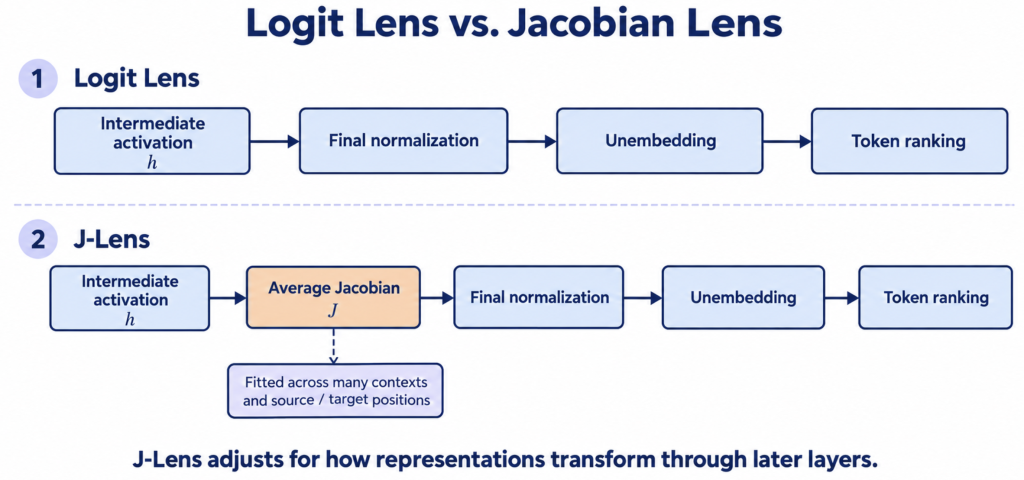
回到 Day 6 的 Logit Lens。它把中間 layer 的 activation,直接送進模型最後的 normalization 與 unembedding,得到 vocabulary ranking:
Intermediate activation
↓
Final normalization
↓
Unembedding
↓
Token ranking
這是一個簡單、很有用的起點。但從這個 activation 到最後輸出之間,其實還有一批 layers 沒有執行。某項資訊即使已經存在,後面的模型仍可能繼續轉換它的表示方式。因此,直接用最後的讀取方式看中間狀態,不一定讀得清楚。例如,Logit Lens 沒有讀到 spider,不代表那裡完全沒有蜘蛛相關資訊;也可能是這項資訊還沒有被轉換成最後的 unembedding 容易讀取的形式。J-Lens 在這裡多做了一步:
先估計中間 activation 如何影響後面的表示,再用模型原本的輸出層讀取它。
假設我們取出第 ℓ 層、第 t 個 token 位置的 activation:

現在沿著某個方向,把它改動一點點。這個改動會經過後續 layers,也可能透過 attention 影響後面的 token positions。Jacobian 描述的就是這種局部關係:
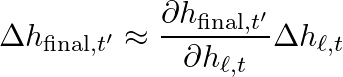
不用被符號嚇到。它只是在問:如果這裡改一點點,最後一層的某個位置會跟著改多少、往哪個方向改?其中,t′ 可以是目前的位置,也可以是後面的位置。但只在一段 prompt 上計算,得到的結果會受到這個特定情境影響。J-Lens 因此會跨不同文本、來源位置,以及目前與後續的目標位置,平均這些 Jacobians:
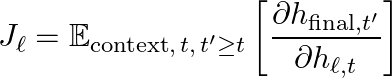
得到的 J_ℓ,是一個從第 ℓ 層映射到最後一層表示空間的平均線性轉換。這裡的「未來位置」,是估計時文本序列中位於來源 token 後面的 positions,不是工具預先知道模型尚未生成的答案。之後讀取新的 activation 時,就可以套用已經估計好的映射:
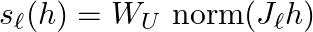
其中:
把 scores 排序,就得到人類可以閱讀的 token list。[1]
但這份 token ranking 想捕捉的是什麼?J-Lens 的映射來自 activation 對目前與後續輸出的平均影響。它想找出的,不只是研究者能從外部解碼的資訊,而是模型本身也能在適當情境下,用語言報告的內部內容。研究者把這種性質稱為 verbalizability(可語言化):模型原本不一定會說出它,但被問起時,有能力把它說出來。
例如,模型可能先形成 spider 相關表示,再利用它算出腿的數量。眼前的問題只要求數量,因此最後輸出的是 8,不需要真的寫出 spider。這讓我們區分「可以被說出口的中間資訊」和「模型現在準備輸出的答案」。 而「模型能報告內部內容」不只是方法的設計目標,論文也另外做了實驗驗證。例如,模型先選定一種運動,J-Lens 讀到 soccer,模型隨後也報告自己選了 soccer;當研究者介入相關表示,模型的報告則跟著轉向 rugby。[1] 所以重點不只是我們能從外部讀到什麼,而是這些表示也能被模型自己的報告過程使用。它們不只是逐漸成型的下一個 token,也可能是當下沒有說出口、但在適當條件下能被報告的內部資訊。
不過,「可以被說出口」不等於「接下來就會說出口」。J-Lens 使用平均線性映射讀取 activation,並沒有實際執行所有後續計算。因此,它的 scores 即使經過 softmax,也不能直接當成模型下一個 token 的真實輸出機率。
如果 spider 在 J-Lens 中排名很高,可以先理解成:
按照這個平均映射,這段 activation 含有與模型說出
spider相關的表示。
但模型下一個 token 不一定要輸出 spider。在剛才的例子中,它真正要回答的是腿的數量。這就是 verbalizable 和 正在被 verbalized 的差別:某項資訊可能處於能被轉成語言的形式,卻沒有直接出現在回答中。不過,一個高排名也不保證模型被追問時一定會說出這個詞,更不表示它就是 activation 唯一的意思。
所以我們需要把三件事分開:
前面的蜘蛛/螞蟻實驗,正是在往第三層證據前進。
研究者也把各個 token 對應的 J-Lens directions 放在一起研究,提出 J-space。這個名稱很容易讓人想像:模型裡有一個小房間,專門放「可以說出口的想法」。但 J-space 不是模型新增的一個 module,也不是一個和其餘 computation 隔開的實體區域。可以用前面 SAE 的經驗來理解:給定一個 activation,我們嘗試從 J-Lens directions 中,挑出少數幾條,用非負係數組合起來,近似原本的向量。
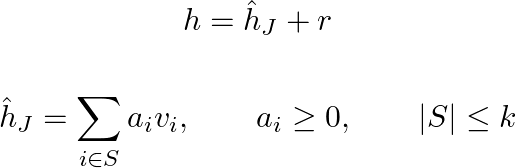
其中:
例如,某個 activation 的一部分,可能可以用少數幾條與當前任務相關的 directions 描述;其餘資訊仍留在 r 中。
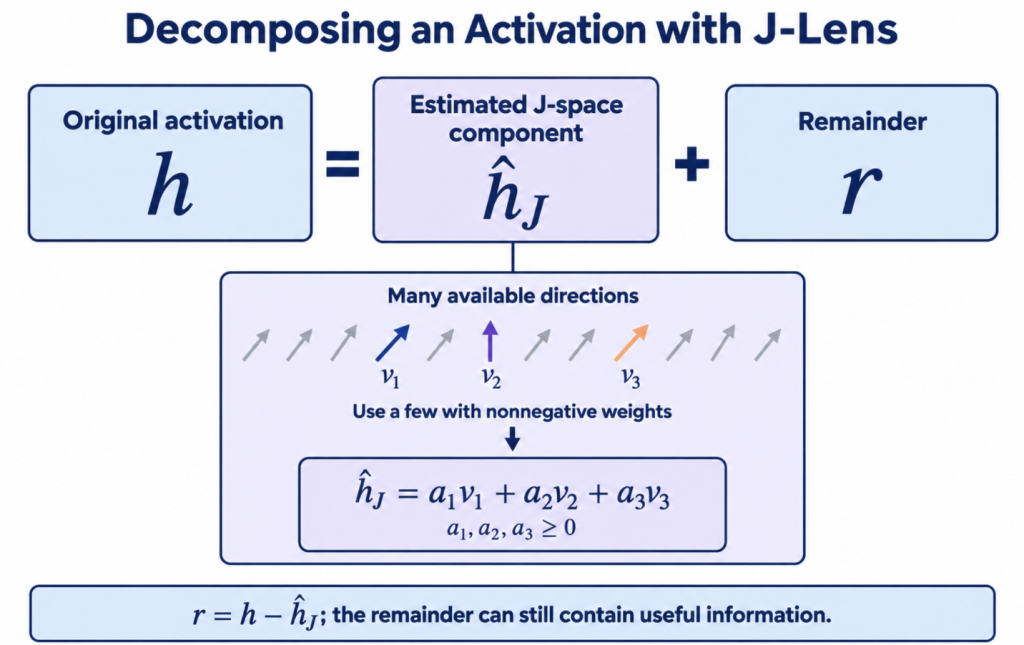
Vocabulary 的大小通常超過 activation 的維度,因此這組 directions 是 overcomplete 的,不是一組彼此獨立的座標軸。允許多少條 directions 參與,也會影響分解結果。另外,top-k readout 和 sparse decomposition 是不同操作。前者只是把 lens scores 排序;後者是在找一組能共同近似 activation 的 directions 與係數。不能把 top-k list 直接當成已經分解完成的「想法清單」。
如果 J-space 只是一種新的讀取方式,故事到這裡還不算特別。真正有意思的是,像前面提到的,研究者發現,這些 representations 不只可以被讀成詞,也在一些實驗中呈現了其他功能。[1]
研究者要求模型選一種運動,再說出答案。在報告前,J-Lens 可以讀到 soccer;介入相關 directions 後,模型的報告也跟著轉向 rugby。這是在檢查:模型最後說出的內容,是否真的受到這些內部表示影響,而不只是 lens 剛好猜中了回答。
另一種實驗要求模型一邊照抄無關的文字,一邊保持對 citrus fruits 的思考。表面輸出沒有提到水果,但中間 readouts 會出現水果相關內容。類似設定也被用來觀察模型在照抄文字時,是否同時保留計算中的資訊。重點不是宣布模型和人一樣「一心二用」,而是:模型內部可被讀出的內容,不必等於當下正在輸出的文字。
假設模型內部表示的是 France,後面的問題可能要問首都、語言、洲別或貨幣。研究者在不同任務中,把相關的 France 表示換成 China,檢查答案是否也會轉向中國的對應資訊。這是在測試:同一項 concept representation,能不能被不同的後續運算使用,而不只是連到某個固定答案。
研究也透過抑制 J-space,觀察哪些行為受到影響。結果支持一種區分:部分需要靈活使用中間資訊的任務受到較大影響,但許多文字生成與較 routine 的處理仍能進行。這不表示其餘資訊不重要,而是說 J-space 並不是整個模型 computation 的代名詞。這些性質,讓研究者聯想到來自人類認知心理學、並在認知神經科學中發展的 Global Workspace Theory(全域工作空間理論)。[2]
這個理論想解釋的是:大腦同時處理大量資訊,為什麼只有其中一部分,會成為我們能注意、報告,並拿來靈活思考的內容?例如,你閱讀一句話時,視覺辨識、字詞辨識與部分語法處理,可以在你沒有逐步察覺的情況下進行。但如果你發現「這句話前後矛盾」,這項資訊就可能被你保留,拿來重新閱讀、搜尋記憶、決定是否相信作者,或直接告訴別人。Global Workspace Theory 提出的想法是:大腦中許多專門的處理程序可以各自運作;部分資訊則會進入一個容量有限的共享工作空間,被提供給不同程序使用。可以把它想成一塊共享白板。重點不是白板能存多少東西,而是寫在上面的資訊,不再只屬於某一個處理程序:它可以被拿來回答問題、做決策,或接續另一段推理。
研究者因此問:語言模型裡,是否也存在一種表示形式,讓少量資訊能被報告、依照指令調整,並交給不同的後續計算使用?前面的 J-space 實驗,就是在檢查這些功能上的相似性。這並不是說 Transformer 裡真的藏著一塊和人腦相同的區域,而是說某些 representations 可能扮演了類似的角色。
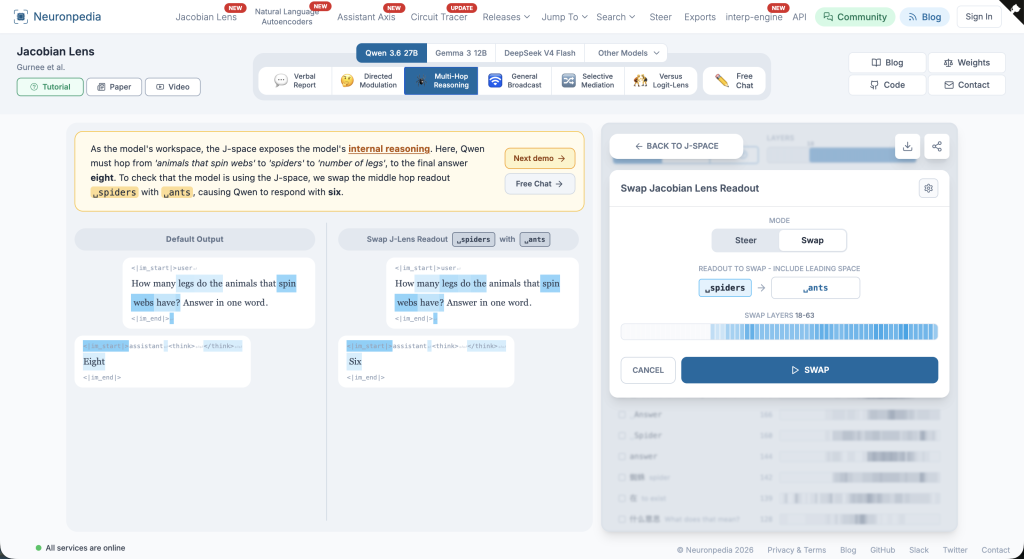
今天可以直接使用 Neuronpedia 的 J-Lens 介面,不必先自己估計 Jacobian。[3] 第一次操作,建議從 Multi-Hop Reasoning 的預設範例開始。先保留預設模型與設定,再逐步測試自己的 prompt,避免一次改太多條件。以蜘蛛問題為例:
The number of legs on the animal that spins webs is
可以依照下面的順序觀察:
spider 或相關 token 是否出現,同時記錄 layer、position 與排名。這裡要特別注意:比較不同 layers,是看同一位置經過更深的計算;比較不同 token positions,則是在看不同文字位置。 兩者不能混成同一條「思考時間線」。接著可以試:
The color of the planet fourth from the Sun is
這次的假說是:模型是否先形成 Mars 相關表示,再轉向顏色答案?但不要把假說當成必然結果。不同模型、問法與位置,可能得到不同 readouts;找不到 Mars,也不能直接推出模型沒有使用火星相關資訊。今天要練習的是:先提出預測,再記錄結果,包括沒有符合預測的例子。
官方釋出了 reference implementation,可以載入模型對應的 pre-fitted lens。[4] 核心流程是:
model = jlens.from_hf(hf_model, tokenizer)

lens = jlens.JacobianLens.from_pretrained(
    lens_repo,
    filename=lens_file,
)
lens_repo 與 lens_file 必須指向和模型相容的 lens,不能拿另一個模型的映射直接套用。接著選定要讀取的 token position:
lens_logits, model_logits, _ = lens.apply(
    model,
    prompt,
    positions=[-2],
)
這裡的 -2 是倒數第二個 token,不是倒數第二個英文單字,也不是第二層。使用前要先確認 tokenizer 切出了哪些 tokens。最後列出各層的 top readouts:
for layer, logits in sorted(lens_logits.items()):
    token_ids = logits[0].topk(5).indices.tolist()
    words = [tokenizer.decode([i]) for i in token_ids]
    print(layer, words)
這是官方介面的使用骨架,不是可以獨立執行的完整實作;仍需要安裝套件、載入模型,以及指定相容的 lens。想進一步操作,可以從官方 repository 的 walkthrough 開始。其中,lens_logits 是 J-Lens 的讀取結果,model_logits 才是模型原本的輸出。不要把兩者混成同一份 next-token prediction。
它們的差別不只是輸出長短,而是怎麼建立 activation 與文字之間的關係。
| 方法 | 怎麼讀取 activation? | 結果 |
|---|---|---|
| Logit Lens | 直接使用最後的 normalization 與 unembedding | Vocabulary ranking |
| J-Lens | 先套用平均 Jacobian 映射,再使用模型的輸出層 | Vocabulary ranking |
| NLA | 讓 verbalizer 產生文字,以 activation reconstruction 提供訓練訊號 | 自然語言 explanation |
| Activation Oracle | 讓訓練過的 interpreter 接收 activation 與問題 | 自然語言回答 |
J-Lens 不會另外生成一段完整故事,告訴你「模型因為 A,所以決定 B」。但這不代表它不需要解讀。看到 danger,不表示已經知道模型在擔心什麼;看到 fake,也不表示已經確認它辨識出了某種評估情境。Token 是線索,不是完整的心理描述。
J-Lens 主要以 vocabulary tokens 為索引。多 token 的名字、複雜關係,或不容易用文字表達的資訊,不一定能被幾個高排名 token 清楚呈現。Jacobian 描述的則是局部線性敏感度,再經過跨情境平均。它不是完整的非線性模型,也不保證大幅 intervention 仍會遵守小幅改動時的關係。J-space 的分解同樣受到 directions 與 sparsity 設定影響。沒有被分解進去,不代表模型不知道;沒有出現在 readout 中,也不代表模型沒有使用。所以我們仍然沿用整個系列的原則:
J-Lens 幫我們提出假說;對照與 intervention,才讓我們逐步檢查這個假說。
「可以報告」「可以保留中間資訊」「可以提供給不同任務使用」,都是可以設計實驗檢查的功能。「是否具有主觀體驗」,則是另一個問題。
這篇研究把部分 representations 和 Global Workspace Theory 聯繫起來,不等於已經證明模型具有感受、痛苦或人類式的意識。即使先不回答這些問題,J-Lens 仍然有實用價值:它讓我們不只看最後輸出,也能追蹤那些沒有寫出來、卻可能影響後續計算的資訊。
走到這裡,我們已經建立了不少外部工具:取出 activation、訓練 probe、分解 features、建立 lens,再設計 intervention 檢查解釋。這些工具讓我們看得更深,但也帶來一個實務問題:模型越來越大、更新越來越快,我們是否每次都得重新搭建一套解讀它的工具?
另一個更有野心的方向是:
能不能讓模型本身,就成為我們理解它內部狀態的介面?
理想情況下,我們不必每次都先取出 activation,再交給另一個 decoder 翻譯,而是能直接詢問模型:你目前保留了哪些資訊?什麼因素正在影響這次回答?剛才的內部狀態發生了什麼變化?這不是第一次回到 self-report。Day 23 的 CoT 已經提醒我們:模型能說出一段理由,不代表那段理由忠實。因此,這個方向不能只停在「請模型解釋自己」,而必須檢查它的報告是否真的受到內部狀態影響。
例如,在 prompt 不透露內容的情況下,往 activation 注入一個 concept,再看模型能否辨識它;沒有注入時,則檢查模型會不會照樣聲稱自己察覺了某個想法。這樣才能逐步區分:模型是在描述實際的內部變化,還是在根據問題編出一段聽起來合理的回答。如果這種能力能被可靠地驗證、甚至進一步訓練,interpretability 就可能不只是模型外面的分析工具,也成為模型本身可以提供的一種能力。外部工具仍然重要,但它們也能用來校驗這個內建介面,而不必承擔所有解讀工作。
下一篇,我們會從 Introspective Interpretability 出發,看看距離「讓模型自己成為解讀介面」這個目標,目前有哪些證據,又還缺少什麼。
[1] Gurnee, W., Sofroniew, N., Pearce, A., et al., “Verbalizable Representations Form a Global Workspace in Language Models”, Transformer Circuits Thread, 2026. https://transformer-circuits.pub/2026/workspace/
[2] Dehaene, S., Kerszberg, M., & Changeux, J.-P., “A Neuronal Model of a Global Workspace in Effortful Cognitive Tasks”, PNAS, 1998. https://www.pnas.org/doi/10.1073/pnas.95.24.14529
[3] Neuronpedia, “Welcome to the J-Space”, 2026. https://www.neuronpedia.org/blog/jacobian-lens
[4] Anthropic, jacobian-lens: Companion Code for the Global Workspace Interpretability Paper, 2026. https://github.com/anthropics/jacobian-lens


 iThome鐵人賽
 看影片追技術